有人开源了 CMP 170HX 驱动补丁,声称解锁 64GB HBM2e 和 173T BF16 算力
原文链接:智选 DIY 装机
作者:智选 DIY 装机 | 发布时间:2026-07-20
版权声明:本文由原作者所有,本站仅作整理发布。转载请注明出处。
CMP 170HX——NVIDIA 当年给矿工做的专用挖矿卡,基于跟 A100 同一颗 GA100 芯片。有人在 GitHub 上开源了一套 Linux 驱动补丁,声称能把这张卡的显存从 8GB 解锁到 64GB HBM2e,BF16 算力解锁到 173 TFLOPS。如果属实,这意味着一张闲鱼约 1320 元的矿卡变成了 A100 的平替。但有一道硬件级的坎:PCIe 只有 Gen2 ×4,带宽 2GB/s。
CMP 170HX 是什么
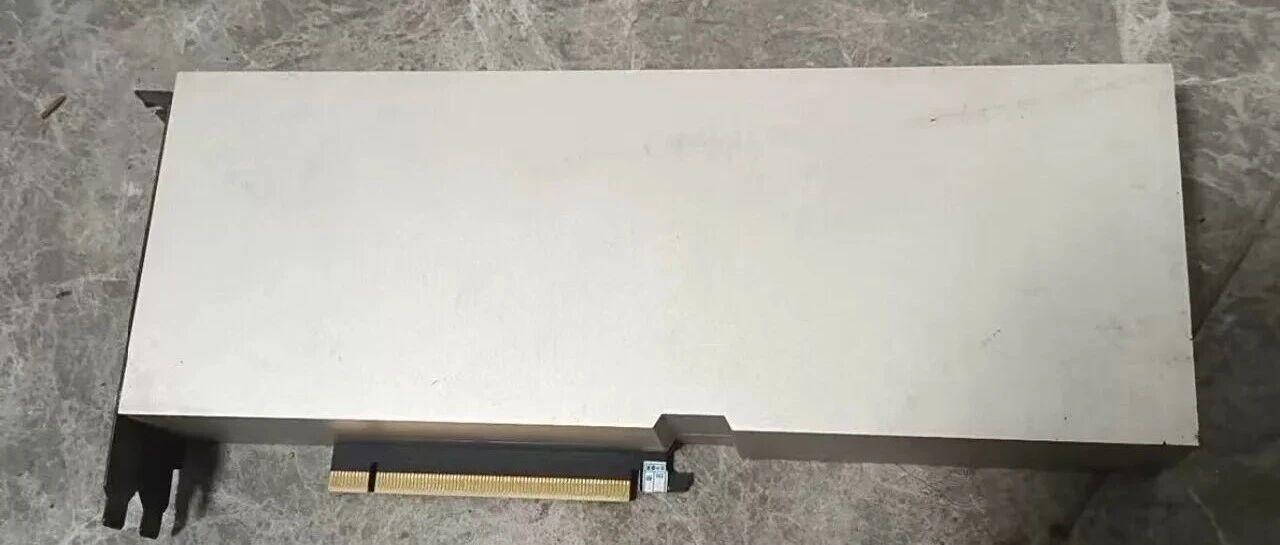
2021 年前后,NVIDIA 出了一批 CMP(Crypto Mining Processor)系列矿卡——专门给矿工设计,没有视频输出,不能接显示器。CMP 170HX 是其中规格最高的型号。
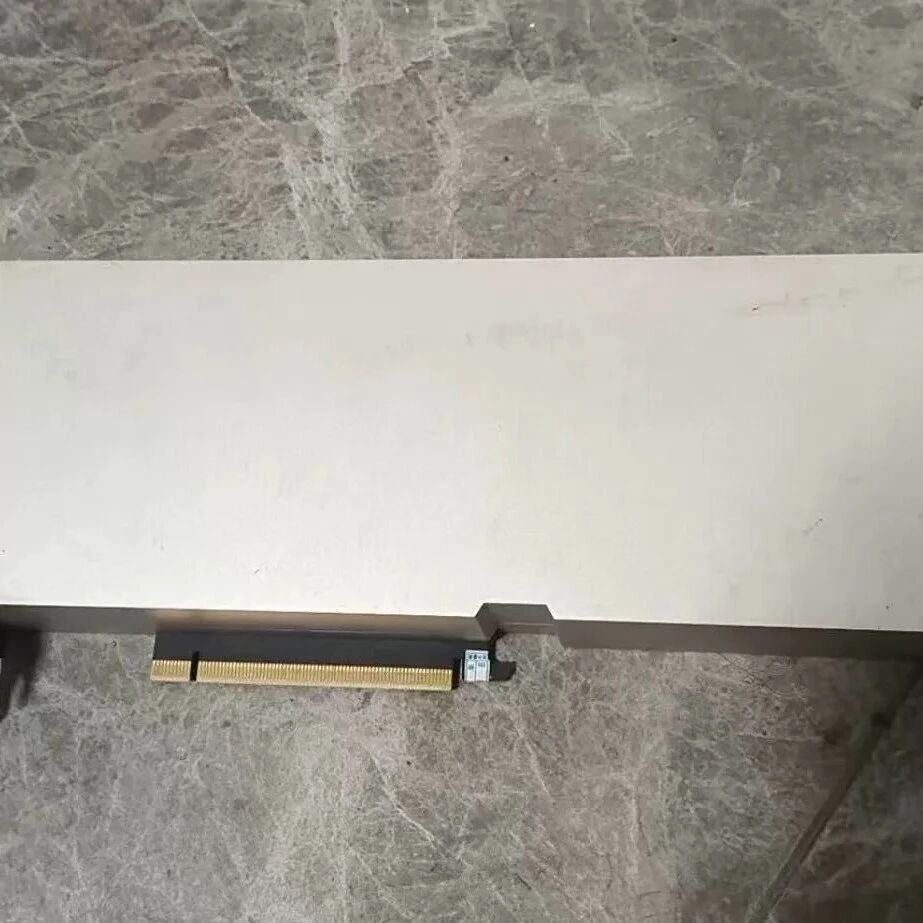
核心参数如下:
| 参数 | 规格 |
|---|---|
| GPU 芯片 | GA100(与 A100 数据中心卡同款芯片) |
| 架构 | Ampere,台积电 7nm |
| CUDA 核心 | 4480 个 |
| 内存 | HBM2e(高带宽内存),出厂固件限制为 8GB |
| TDP | 250W |
| 接口 | PCIe Gen2 ×4(硬件限制,不可解锁) |
| 视频输出 | 无 |
核心参数取自 NVIDIA 官方规格页与 TechPowerUp GPU Database。
A100 80GB 版本的稠密 BF16 算力约 312 TFLOPS(不含稀疏加速,稀疏口径为 624T)。CMP 170HX 用的是同一颗 GA100 但有所裁剪,CUDA 核心少了约三分之一。
解锁了什么
这位开发者发布的驱动补丁基于 NVIDIA 610.43.03 版本的开源内核模块,做了修改后重新编译。
该项目声称解锁后的结果:
| 项目 | 出厂状态 | 解锁后(声称) |
|---|---|---|
| 显存 | 8 GB HBM2e | 64 GB HBM2e |
| BF16 算力 | 受限 | 173 TFLOPS |
| PCIe | Gen2 ×4 | Gen2 ×4(无变化) |
显存从 8GB 到 64GB——如果属实,意味着这张卡的 PCB 上本来就焊了完整的 HBM2e 内存堆栈,只是被出厂固件锁死在 8GB。驱动补丁解除了这个固件限制。
项目提供了 gpu_burn 压力测试步骤,测试 63.5GB 显存 30 秒,预期 0 错误——这是验证解锁是否真实的关键步骤。
需要注意的几件事
一、还没有人独立验证
截至发帖,没有第三方独立复现这个解锁结果。评论区多数反馈是"卡还在路上,到了试试"——也就是说,除了作者本人,暂时没人亲手跑通过。
更值得注意的是,有评论者审计了 GitHub 上的代码,给出的结论是开箱运行不正常,需要额外修改才能跑起来(系评论区个人说法,非官方结论)。还有人追问 PCIe Gen1-2 相关的已知问题是否修复,作者尚未回应。
项目本身提供了 gpu_burn 压力测试步骤——测试 63.5GB 显存跑 30 秒,预期 0 错误。在有人独立跑通这个测试之前,64GB 解锁都只是声称。
二、PCIe ×4 是硬件级限制
PCIe Gen2 ×4,带宽只有约 2GB/s。这是 PCB 上缺少 AC 耦合电容导致的硬件限制——4-15 号通道物理上不通,驱动改不了。
作为参考:A100 PCIe 版是 Gen4 ×16,带宽约 32GB/s。CMP 170HX 的 PCIe 带宽只有 A100 的十六分之一。
这意味着:
- 模型加载慢。64GB 模型从系统内存搬进显存需要约 30 秒
- 多卡通信受限。如果想多张 CMP 170HX 并联做推理,卡间通信带宽只有 2GB/s
- 单卡推理影响有限。模型一旦加载进 HBM2e,推理计算在 GPU 内部完成,HBM2e 内部带宽约 1.5TB/s 不受 PCIe 影响
单张卡跑本地大模型推理是最合理的用法——模型全载入显存后,PCIe 带宽瓶颈可以忽略。
三、仅限 Linux
补丁基于 NVIDIA 的开源内核模块,只支持 Linux(Fedora、Ubuntu、Debian、Arch、openSUSE)。Windows 不支持。安装过程需要编译内核模块,需要 root 权限和内核头文件。
四、多卡兼容
两张 CMP 170HX 可以共存,各自独立解锁。跟其他 NVIDIA 显卡(如 RTX 系列)也能共存——补丁只对 CMP 170HX 的设备 ID 生效,不影响其他卡。
如果 64GB 是真的,意味着什么
64GB HBM2e + 173 TFLOPS BF16——这是 A100 级别的 AI 推理能力。
参考对比:
| 显卡 | 显存 | BF16 算力 |
|---|---|---|
| RTX 3090 | 24GB GDDR6X | ~71T |
| P40 | 24GB GDDR5X | 无 BF16 |
| A100 80GB | 80GB HBM2e | 312T(稠密) |
| CMP 170HX 解锁(声称) | 64GB HBM2e | 173T |
价格差距是这个项目引人注意的根本原因。CMP 170HX 8G 闲鱼行情约 1320 元(07-17 查价),A100 80GB 闲鱼长期在万元以上。如果解锁属实,花 A100 零头的钱就能拿到它大半的推理能力。
64GB HBM2e 能完整装入 Qwen 3.6 35B 的全精度模型,或者 70B 模型的 Q4 量化版本——这是目前 RTX 3090(24GB)和 P40(24GB)做不到的事。
HBM2e 的带宽优势(约 1.5TB/s)在大模型推理中尤其明显——推理速度高度依赖显存带宽,HBM2e 比 GDDR6X 快了一个量级。
但前提是:你手上的卡确实有 64GB 物理内存,且 gpu_burn 压力测试通过。
冷静看待
这个项目刚发布,社区还在验证阶段。闲鱼行情约 1320 元一张。赌赢了是 64GB HBM2e 的准 A100 推理卡,赌输了是一张 8GB 无显示输出的矿卡——这个赔率是社区愿意关注它的原因。
如果你感兴趣但不想冒硬件风险,源文评论区有人提到这卡在部分算力租赁市场上也能租到,价格大约是 A100 的一半——先租一张验证解锁效果,确认了再考虑买。
如果要直接买:
- 拿到卡后第一件事刷补丁、跑 gpu_burn 压力测试,验证显存容量
- 在有独立复现报告之前,做好"解锁可能不成功"的心理准备
项目地址: github.com/amoghmunikote/cmpunlocker(开源,可审计代码)
FAQ
Q1:Windows 能用吗?
不能。补丁基于 NVIDIA 开源内核模块,仅支持 Linux 发行版。
Q2:PCIe Gen2 ×4 会不会严重影响性能?
模型加载阶段会慢(64GB 模型约需 30 秒),但推理时数据主要在 GPU 内部 HBM2e 中流转(带宽约 1.5TB/s),PCIe 瓶颈影响有限。
Q3:解锁一定成功吗?
不一定。目前没有第三方独立验证。有评论者指出代码可能需要额外修改才能正常运行。建议先租卡验证,再考虑购买。
Q4:能跑哪些模型?
64GB 显存可以完整装入 Qwen 3.6 35B 全精度模型,或 70B 模型的 Q4 量化版本。
Q5:多卡能叠加使用吗?
两张可以共存并各自独立解锁,但卡间通信受限于 PCIe Gen2 ×4 的 2GB/s 带宽,多卡推理收益有限。
本文根据微信公众号「智选 DIY 装机」原文整理发布,版权归原作者所有。